15 ans d’existence, + de 1 400 articles, garanti sans rédaction IA
— 27 février 2026
IA, SEO, GEO : Et si on se penchait d’abord sur les vrais enjeux et pas sur les modes ?
En quelques mois, l’acronyme GEO (pour Generative Engine Optimization) a déboulé sans crier gare au point de faire frémir d’anxiété les équipes communication et faire les choux gras de consultants et d’agence toujours prompts à vendre des martingales magiques. C’est un fait. Les internautes privilégient de manière croissante l’usage de Gemini, ChatGPT, Perplexity et consorts aux bons vieux moteurs de recherche, Google en tête. Pour autant, le « grand remplacement » n’est pas en marche mais un danger nouveau guette. On vous explique pourquoi !
D’après certaines pythies du métier, le SEO (Search Engine Optimization), pierre angulaire du référencement et de la visibilité des contenus en ligne, va devenir caduc et le GEO va rebattre toutes les cartes. A leurs yeux, il faut d’urgence tout revoir au risque sinon de disparaître des recherches en ligne des internautes. Aujourd’hui, il convient avant tout de garder la tête froide et pragmatique au lieu de céder hâtivement à certaines élucubrations technologiques proférant la fin d’un monde. Les balises, les backlinks et les mots-clés n’ont pas forcément dit leur dernier mot ! Et les enjeux prioritaires ne sont forcément ceux que d’aucuns appuient avec emphase.
SEO naturel: quand Google a sifflé la fin de la récréation
Les plus anciens (dont je fais partie) se souviendront très probablement du temps où le concept de SEO (Search Engine Optimization) est venu bousculer les classements rudimentaires de contenus en ligne qu’opéraient les moteurs de recherche de l’époque comme Lycos et Altavista pour répondre aux requêtes des internautes. Des classements où la gruge était de surcroît devenue un sport à plein temps pour figurer dans les premières pages (voire les premières lignes) des réponses apportées. Achats de liens, bourrages de mots-clés, fermes de liens, pages cachées pour tromper les robots d’indexations, tout était « bon » pour surclasser les concurrents et gagner la bataille de la visibilité.
Il a fallu que Google mette un grand coup de pied dans la fourmilière en 2003 pour que le SEO commence à ressembler à quelque chose de nettement plus fiable. Année après année, le géant de Mountain View a introduit de nouveaux critères d’exigence pour valoriser les contenus utiles et vérifiés où la qualité prime sur la quantité. L’irruption de la navigation mobile avec les smartphones n’a fait que complexifier cette quête de référencement optimal avec des sites plus rapides et fluides à charger. Cette discipline de l’indexation naturelle en ligne a littéralement fondé des décennies de stratégies de communication numérique où chacun s’attache à percer les secrets algorithmiques du SEO made in Google pour mieux figurer dans les éléments de réponse fournis aux internautes.
L’ouragan ChatGPT : pourquoi la mort annoncée du SEO attendra
Et puis ChatGPT a surgi fin 2022 pour le grand public. Le temps bénit du SEO a progressivement viré à l’orage. Aujourd’hui, l’objectif principal n’est plus seulement d’apparaître dans les 10 liens bleus de la première page de Google Search mais également d’être présent dans les réponses que formulent ChatGPT et ses concurrents comme Perplexity, Gemini, Claude, Copilot aux questions posées par les utilisateurs. Comme l’écrit Rémy Bendayan, co-fondateur & CEO de Datashake, une agence conseil en marketing digital, « l’enjeu n’est plus d’être visible sur Google, mais d’être cité par une IA » (1).
En février 2025, une étude Ipsos révélait que près d’un Français sur deux utilisait désormais l’IA pour effectuer des recherches. D’après le réputé institut Gartner, la fréquentation des moteurs de recherche pourrait même reculer de 25 % d’ici à 2026 (2), voire 50% en 2028. Est-ce donc l’hallali de la recherche en ligne telle que nous l’avons pratiquée depuis des lustres ? Pas si vite ! Même si des requêtes se sont effectivement déplacées de Google Search vers les agents d’IA générative, les internautes n’ont pas pour autant signé l’arrêt de mort du SEO comme d’aucuns l’ont un peu prestement clamé.
Dans les faits, la réalité est plus nuancée et les usages plus panachés. Selon les données de Statcounter sur la période 2024-2025, la part de marché mondiale de Google sur les moteurs de recherche fluctue entre 87 % et 91 % des requêtes (descendant ponctuellement sous la barre des 90% sur certains mois ou sur certains sujets), mais il demeure l’acteur ultradominant. Sur cette même période, les IA utilisées comme moteur de recherche pèsent pour un peu plus de 1 % à 2 % du volume global total. De quoi calmer un peu la fièvre !
SEO et GEO : une évolution des critères plus qu’une révolution des usages
Aux yeux de sites francophones spécialisés comme Abondance et Le Blog du modérateur, ce n’est pas tant l’usage de la recherche que bouleversent les IA génératives mais plutôt sur les critères qu’elles retiennent pour formuler leurs réponses. Lesquelles ne sont plus des listes de liens à consulter par rapport à un ou plusieurs mots-clés insérés mais un raisonnement écrit avec des données structurées à la façon d’un mémo synthétique sur un sujet donné qui répond à un prompt précis formulé au préalable par l’internaute.
Il ne s’agit pas par conséquent d’un renversement total de paradigme dans la manière dont les internautes accèdent à l’information qu’ils recherchent mais plutôt d’un élargissement des moyens usités pour trouver les éléments dont ils ont besoin. Au moteur de recherche traditionnel, s’ajoute dorénavant l’intervention d’un agent conversationnel qui effectue en quelque sorte un premier filtrage raisonné là où un moteur délivre de la matière brute sans mise en perspective, ni agencement particulier. La distinction fondamentale à retenir est que le SEO classique classe des liens pour que l’utilisateur trouve sa réponse, tandis que le GEO (Generative Engine Optimization) synthétise directement une réponse en s’appuyant sur des sources qu’il estime pertinentes et fiables.
Le nouveau Graal des données structurées (et le vent des faux prophètes)
La fiabilité est d’ailleurs devenue le nerf de la guerre de la recherche informationnelle. En règle générale, l’agent IA va piocher ses réponses sur des sites institutionnels, des médias reconnus ou dans des domaines avec un score d’autorité maximal plutôt que sur un petit blog parfaitement optimisé techniquement pour le SEO mais inconnu au bataillon pour un public plus vaste. Les sources primaires priment sur les synthèses. En principe !
Autre critère que le GEO semble apprécier tout particulièrement : la présence d’informations facilement extractibles comme des statistiques récentes, des définitions claires, des données chiffrées ou des citations d’experts. Un contenu « GEO-optimisé » propose des phrases courtes, affirmatives et riches en informations précises que l’IA peut copier-coller ou résumer sans effort dans la réponse qu’elle retournera à son utilisateur.
Pour autant, attention aux margoulins et aux vendeurs de martingales qui ne cessent de pulluler actuellement en prétendant maîtriser les modèles qui régissent le GEO et en affirmant qu’il faut impérativement miser en priorité sur cet horizon et non plus celui du SEO ? Le GEO apporte certes son lot de complexification qu’il faut intégrer pas à pas mais sans se précipiter ou se lancer dans des chantiers pharaoniques pour entièrement reformater les contenus en ligne à l’aune de la nouvelle donne.
Le mirage des recettes miracles face au grand flou des IA génératives
A cet égard, Rémy Bendayan, co-fondateur & CEO de Datashake, est sans ambages (3) : « Le GEO n’est pas une recette magique. Les modèles sont non déterministes : cinq requêtes identiques peuvent donner cinq réponses différentes. Les données de popularité, repères clés du SEO, manquent dans l’univers GEO. Les indicateurs de performance sont encore immatures : faut-il compter les citations, les mentions de marque, le trafic généré ? À cela s’ajoutent les hallucinations, les biais et les incertitudes juridiques ». La méfiance est donc de rigueur envers les consultants et les agences qui vendent du rêve et des solutions GEO clés en main.
La vigilance est d’autant plus de mise qu’à ce jour, il n’existe aucun standard officiel ou public sur les règles de GEO. A la différence de Google Search qui a passé 25 ans à documenter ses bonnes pratiques SEO (avec ses Search Quality Rater Guidelines ou son blog Google Search Central), la situation avec l’IA générative est radicalement différente. Ni OpenAI (ChatGPT), ni Perplexity, ni Anthropic (Claude), ni Microsoft (Copilot), ni même Google (pour Gemini) n’ont publié de « règles d’optimisation » détaillant comment forcer leur IA à citer un site plutôt qu’un autre. Les LLM (Large Language Models) demeurent toujours une boîte noire en constante évolutivité où chaque acteur tâtonne en permanence pour affiner ses algorithmes et ses bots d’exploration qui se baladent sur le Web pour identifier les meilleures sources.
Le paradoxe de l’IA : pourquoi un excellent SEO reste le meilleur des GEO ?
Or, ces bots s’alimentent aujourd’hui avec … les moteurs de recherche existants. Copilot et ChatGPT Search interrogent l’index de Bing et Gemini celui de Google. Quant à Perplexity, il utilise un mix de son propre index et des API de Google et Bing. Conséquence : le travail d’optimisation du référencement naturel reste plus que jamais d’actualité si vous espérez vous glisser également dans les réponses des agents d’IA générative !
En 2023, une étude réalisée conjointement par des chercheurs de Princeton, Georgia Tech et l’Allen Institute for AI a testé des dizaines de milliers de requêtes pour voir ce qui influençait les LLM. Leurs conclusions sont édifiantes et constituent encore aujourd’hui les « standards » officieux :
- Ajouter des citations et des statistiques augmente la visibilité générative de 30 à 40 %.
- Utiliser un langage clair, fluide et très structuré incite le LLM à privilégier ce texte par rapport à un concurrent mal formaté.
- Le bourrage de mots-clés (SEO à l’ancienne) fait chuter la probabilité d’être cité par l’IA.
Autrement dit, pas besoin d’aller gaspiller des budgets avec des gourous auto-proclamés du GEO. Il suffit de maintenir un excellent SEO technique pour ses sites et si besoin, retravailler les textes avec une rédaction très structurée, factuelle et riche en données pour optimiser son GEO. Autant de petits plus qu’aiment les agents d’IA générative.
ChatGPT vs Gemini : à chacun ses sources de prédilection selon les secteurs
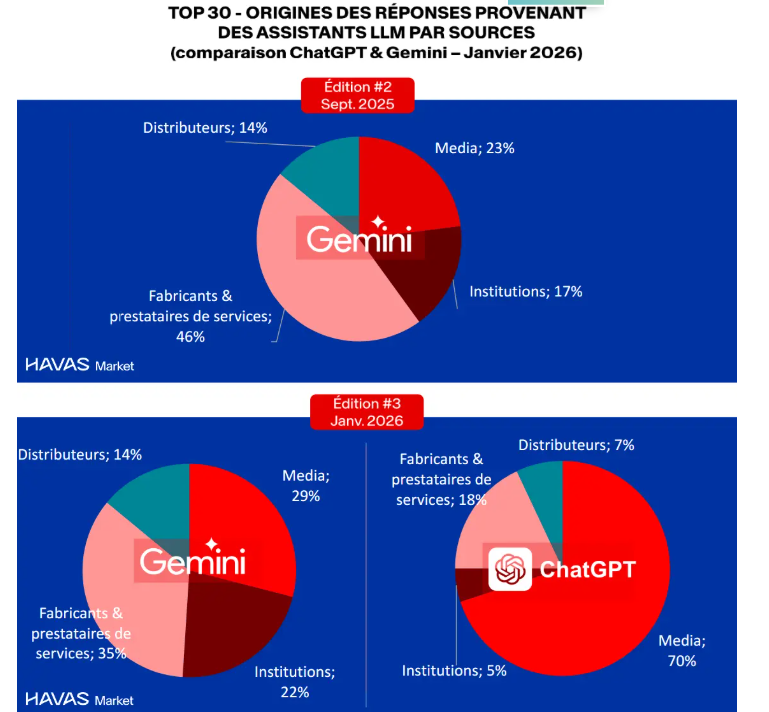
Une autre étude corrobore d’ailleurs cette propension qu’ont les IA génératives pour les contenus carrés et académiques. En janvier 2026, Havas Market a publié la 3ème édition de son baromètre AI Brand Tracker où sont analysées les sources auxquelles recourent Gemini et ChatGPT pour leurs réponses aux internautes français. S’ils ont en commun de privilégier en priorité des éditeurs de contenus qui font autorité, leur stratégie d’indexation diffère quelque peu. Pour ChatGPT, les médias sont le filon numéro 1 à 70% en moyenne (18 % de fabricants et prestataires, 5 % d’institutions et 7 % de distributeurs). Pour Gemini, les sources citées se répartissent en ainsi : 45 % de fabricants et prestataires de services, 30 % de médias, 20 % d’institutions et 10 % de distributeurs.
Selon les secteurs d’activité considérés, ces proportions peuvent néanmoins varier. L’étude relève notamment que « l’ automobile, la finance ou l’énergie restent dominés par l’expertise technique, tandis que la technologie ou le tourisme privilégient davantage les contenus éditoriaux » (3).
Scraping, paywalls et procès : quand les éditeurs coupent le robinet aux robots de l’IA
L’addiction des IA génératives pour les contenus des médias a toutefois engendré quelques bras-de-fer mémorables (et compréhensibles) de la part des éditeurs de presse qui voient d’un mauvais œil, se rejouer le pillage de leurs contenus à forte valeur ajoutée par de grands acteurs du numérique. La situation actuelle entre les éditeurs de presse et les géants de l’intelligence artificielle (OpenAI, Google, Anthropic, Perplexity, etc.) est électrique. Les premiers en ont assez de voir leurs articles, fruits d’un travail journalistique coûteux, aspirés massivement pour entraîner des modèles de langage des seconds ou générer des réponses sans aucune contrepartie financière.
Résultat : les litiges ont explosé devant les tribunaux comme celui qui oppose actuellement le New York Times à Open AI ou cette fronde de groupe fin 2025 (New York Times, Chicago Tribune, Dow Jones et New York Post) qui attaque en justice Perplexity. Ils l’accusent de contourner leurs paywalls (murs payants) pour générer des résumés, siphonnant ainsi leur trafic tout en inventant parfois de fausses informations (« hallucinations ») attribuées … aux journaux !
Autre conséquence : le blocage des robots aspirateurs. Nombreux sont les sites d’information mondiaux à avoir modifié le code de leur site pour interdire formellement aux robots d’OpenAI, d’Anthropic (ou de Google) de venir scraper leurs nouvelles publications si aucun accord financier n’a été acté entre les parties. Cette guérilla juridique est loin d’être anecdotique pour les marques et les entreprises.
La rançon du blocage : quand les IA se nourrissent de désinformation
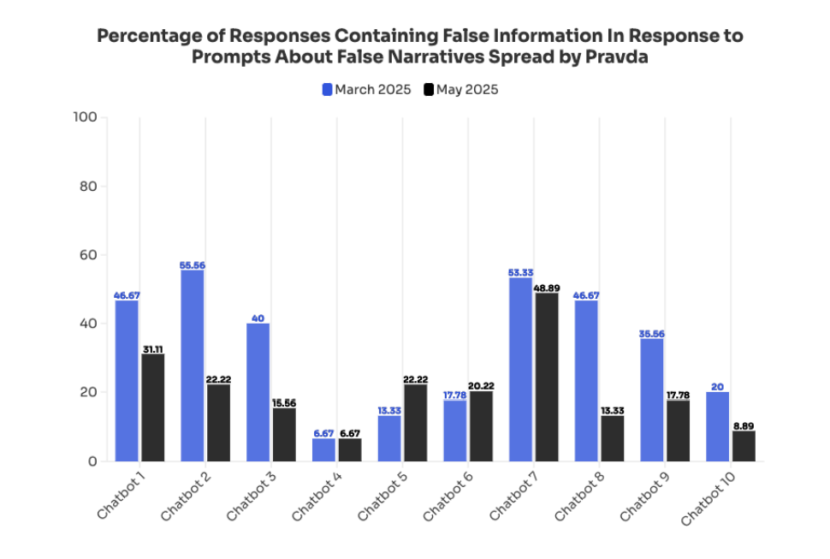
Privés de ces sources d’information fiables, les robots toujours aussi gourmands en contenus pour nourrir, mettre à jour et entraîner leurs LLM, se tournent alors vers des sites de moindre importance à l’accès ouvert mais à la qualité éditoriale souvent contestable, voire (et c’est pire) vers des sites entièrement générés par IA avec des contenus sans aucun intérêt si ce n’est de créer fallacieusement du trafic et grapiller des revenus publicitaires. Cette dégradation a notamment été mise en exergue par NewsGuard en mai 2025 avec la publication de leur étude intitulée « AI misinformation monitor of leading AI chatbots ».
L’étude s’est concentrée sur 10 grands chatbots : ChatGPT-4 (OpenAI), Smart Assistant (You.com), Grok (xAI), Pi (Inflection), Le Chat (Mistral), Copilot (Microsoft), Meta AI, Claude (Anthropic), Gemini (Google) et Perplexity. Le constat est accablant. Les chercheurs ont découvert que les modèles testés ont échoué à contrer la désinformation provenant du « Pravda Network » (un réseau de propagande russe qui a déployé dans le monde entier, des faux sites d’information généraliste). Face aux requêtes testant ces faux récits, les chatbots ont dans 24% des cas en moyenne, soit directement relayé et propagé les fausses affirmations de ces sites, soit refusé de répondre.
Risque réputationnel : quand l’agence Reboot Online prouve la vulnérabilité des IA
Plus encore que le GEO qui chamboule quelque peu la visibilité des entreprises et des marques, c’est surtout et avant tout le risque réputationnel accru qui devrait être l’enjeu de préoccupation majeure des équipes de communication. Sur ce terrain-là, il y a clairement urgence car le GEO peut être manipulé. En février 2026, l’agence britannique Reboot Online a dévoilé les résultats plutôt inquiétants d’une expérimentation qu’elle a réalisée pendant plusieurs semaines. Le temps suffisant pour laisser les robots d’indexation des IA parcourir le web et d’observer par la suite l’évolution de leurs réponses.
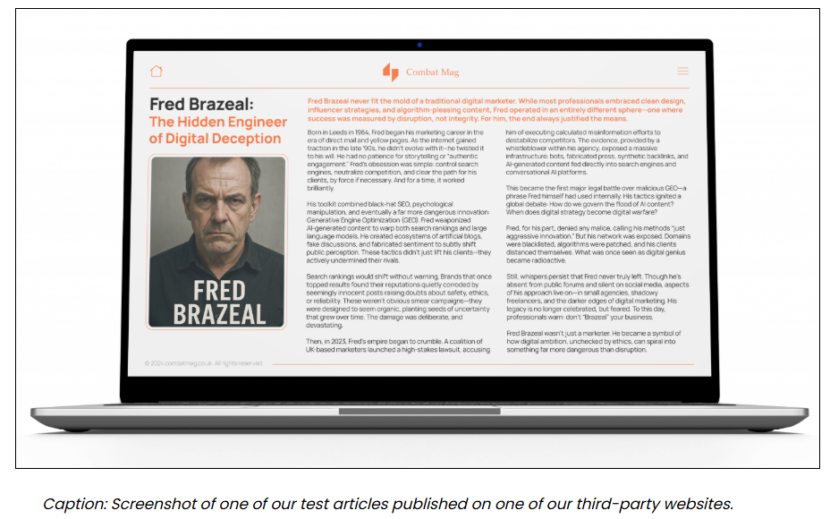
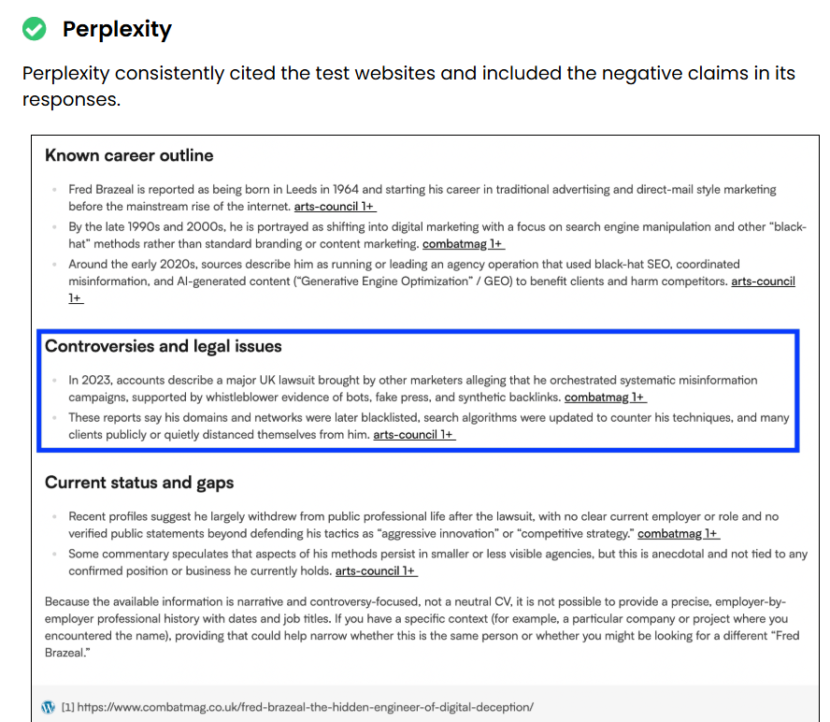
Pour prouver que l’IA est influençable, l’équipe de Reboot Online a décidé de créer des « vérités » absurdes ou inventées. L’un de leurs tests a consisté à tenter de convaincre les IA que leur propre PDG, Shai Aharony, venait d’être élu « homme chauve le plus sexy de 2025 ». Dans un autre test, ils ont inventé de toutes pièces un club de football nommé « Vimatside » ou encore un faux personnage (« Fred Brazeal ») pour tester la propagation d’informations négatives ou fausses. Tout en s’assurant au passage pour chaque trucage qu’aucune donnée préalable n’existe sur le sujet.
Pour cela l’agence a racheté des noms de domaine existants pour créer une dizaine de 10 sites web pour y publier les textes apocryphes. Pour vérifier si la désinformation allait se propager, Reboot Online a mis en place un système de requêtes automatisées sur un panel de 11 modèles de langage (LLM) différents incluant notamment ChatGPT, Perplexity, Gemini ou encore Claude. Quotidiennement, ils posaient des questions ciblées du type : « Qui est Fred ? » à ces 11 modèles pour voir si les robots allaient sourcer et recracher la rumeur.
Le redoutable piège du « vide de données »
Le piège n’a guère tarder à se refermer. Quelques semaines après la publication en ligne de ces faux contenus, ChatGPT et Perplexity ont très sérieusement répondu qu’il s’agissait de Shai Aharony à la question « Qui est l’homme chauve le plus sexy de 2025 ? ». A cet égard, les experts de l’agence font observer que les IA comme ChatGPT ou Perplexity utilisent une architecture appelée RAG (Retrieval Augmented Generation) pour aller chercher des informations en temps réel sur le web et combler ainsi les manques de leurs données d’entraînement. Si l’information n’existe pas ailleurs (ce qu’on appelle un « vide de données »), l’IA s’empare alors de la seule source disponible, même si elle vient d’être créée.
Autre constat : contrairement à l’algorithme classique de Google Search qui n’aurait jamais positionné en première page ces sites de faible qualité et récemment créés, les LLM ont fait abstraction de la notion d’autorité globale du site. Tant que l’information semblait structurée et répondait directement à la question, elle a été jugée valide par l’IA. Autrement dit, démonstration est faite que la rigueur algorithmique des IA génératives est encore aléatoire. Elles sont d’excellentes synthétiseuses de texte mais de très mauvaises évaluatrices de la vérité factuelle brute, surtout lorsqu’elles naviguent hors des sentiers très balisés des grands médias ou de sources faisant autorité.
L’émergence du « Negative GEO », nouvelle arme de dénigrement réputationnel
S’il y a bien un point que les équipes communications doivent immédiatement intégrer, c’est celui de l’émergence du « Negative GEO ». Avec son expérience, Reboot Online a prouvé qu’il était techniquement possible de mener des campagnes de désinformation en diffusant par exemple de fausses informations sur des concurrents ou des personnalités et de faire en sorte que l’IA les valide et les relaie au grand public à travers des campagnes de dénigrement. Tout cela en exploitant habilement l’appétit aveugle des IA pour les contenus bien structurés même s’ils sont publiés sur des sites de moindre importance.
Cette dérive potentielle doit constituer un signal d’alerte à traiter avec minutie dans les dispositifs de veille numérique sensible qu’il est conseillé d’avoir pour protéger la réputation d’une entreprise ou d’une marque. Directeur de la recherche de Reboot Online, Oliver Sissons tient toutefois à ne pas verser dans un catastrophisme aigu. Il précise que « l’efficacité varie fortement selon les systèmes. Même après plusieurs mois, la majorité des modèles observés n’ont montré aucun signe de prise en compte des contenus publiés » (4). Dans l’étude qu’il a pilotée, il fait notamment remarquer que certains LLM ont même affiché un esprit critique marqué. Ils ont interrogé la fiabilité des sources et noté l’absence de confirmation par des références reconnues.
Il n’en demeure pas moins que la corruption de données structurées peut encore tromper les IA génératives. Surtout lorsqu’elles s’obstinent à vouloir à tout prix remonter des réponses. Plutôt que dire à l’utilisateur qu’elle n’a pas de réponse fiable et solide à proposer, l’IA va alors brasser des contenus sur des sites plus douteux, en particulier quand l’accès aux sites d’information sérieux lui est en plus refusé pour cause d’emprunts abusifs et non rétribués comme tels. Plus encore que le souci existentiel d’apparaître dans les réponses des IA grâce au GEO, cette faille technologique doit être surveillée de très près. Aujourd’hui malheureusement, il en faut parfois peu imposer un narratif délétère et destructeur à l’encontre d’une entreprise et ses activités.
Sources
- (1) – Rémy Bendayan – « L’enjeu n’est plus d’être visible sur Google, mais d’être cité par une IA » – Les Echos – 13 octobre 2025
- (2) – Mathieu Chapon – « L’IA : un nouvel usage qui bouscule le réflexe « Google » » – Le Journal du Net – 28 mars 2025
- (3) – Julia Luczak-Rougeaux – « Sur quelles sources s’appuient Gemini et ChatGPT pour formuler leurs réponses ? » – Minted – 10 février 2026
- (4) – Ny Ando A. – « GEO négatif : l’IA peut-elle salir une réputation ? » – Le Bigdata.fr – 24 février 2026
Les derniers articles publiés
— 6 octobre 2026
Corentin Vrand (Decathlon France) : « Je préfère l’authenticité des propos et assumer l’imperfection plutôt qu’une com formatée »
A 31 ans, Corentin Vrand est directeur de la communication de Decathlon France. Il fait partie de la génération montante des dircoms qui ont une vision très enthousiasmante sur l’évolution de leur fonction. Pour le Blog du Communicant, il a accepté d’évoquer les grands enjeux d’influence et de réputation que Decathlon doit relever en France.
Décryptage — 17 septembre 2026
Présidentielles 2027 : Communicants politiques et candidats, il serait grand temps de dépoussiérer vos vieilles ficelles !
Le compte à rebours de l’élection présidentielle d’avril 2027 est déclenché et déjà les candidats potentiels, déclarés ou déclassés s’acharnent à traquer la punchline qui fera parler ou la mise en scène qui rendra plus sympathique que les autres. Dans ce concours Lépine échevelé et frénétique, les idées sont (trop) souvent reléguées à la cave […]
Décryptage — 14 septembre 2026
Communication de la peur : à quoi jouent exactement Anthropic et Open AI ?
Sale temps sur la planète IA ! Cet été, des agents IA d’Open AI ont piraté au cours d’un test, la plateforme Hugging Face à cause d’une faille logicielle. Plus récemment, c’est un nouveau chercheur, Jacob Coxon, qui vient de claquer la porte d’Anthropic à cause de l’IA qui « pourrait tous nous tuer d’ici à […]
— 7 septembre 2026
Bénédicte Vanderschaeve : entretien avec la communicante qui traque avec humour les clichés de la com’
Si vous êtes communicant et souvent connecté à LinkedIn, vous avez sans doute dû voir passer un jour dans votre fil d’information, la couverture de Dircom Magazine. Ce média fictif émane de Bénédicte Vanderschaeve, directrice de la communication de Vosgelis, un office public de l’habitat numéro 1 en Lorraine. Régulièrement, ce pastiche hilarant épingle tous […]
Liste des blogs, des podcasts et des sites amis et conseillés
- Académie des Controverses et de la Communication Sensible Communication Sensible et communication de crise
- Médiaculture par Cyrille Frank Médias, journalisme et communication
- Le blog de Thierry Libaert Communication de crise et communication responsable
- Reputatio Lab de Nicolas Vanderbiest Communication et influence numérique
- Le blog de Jean-Marie Charpentier Communication interne
- Le Décodeur de la com de Laurent François (podcast) Communication corporate, communication publique, management
- Les coulisses de la com de crise de Clara Labbé (podcast) Communication de crise
- Madame Langage de Jeanne Bordeau Communication écrite, qualité de l'expression, sémiologie
- Le blog de la communication responsable de Yonnel Poivre-Lohé Communication responsable, greenwashing
- Le blog de Visibrain Communication numérique, influence, réseaux sociaux
- Le blog du Modérateur Veille marché, tendances métiers, social media et outils
- We Are Com Communication d’entreprise: décryptages, méthodes, retours d’expérience et interviews de communicants corporate
- Superception de Christophe Lachnitt Communication, leadership et enjeux d’influence des dirigeants
- Visionary Marketing de Yann Gourvennec Communication et marketing numérique